In dieser Anleitung
Was ist OCR und wofür ist sie nützlich?
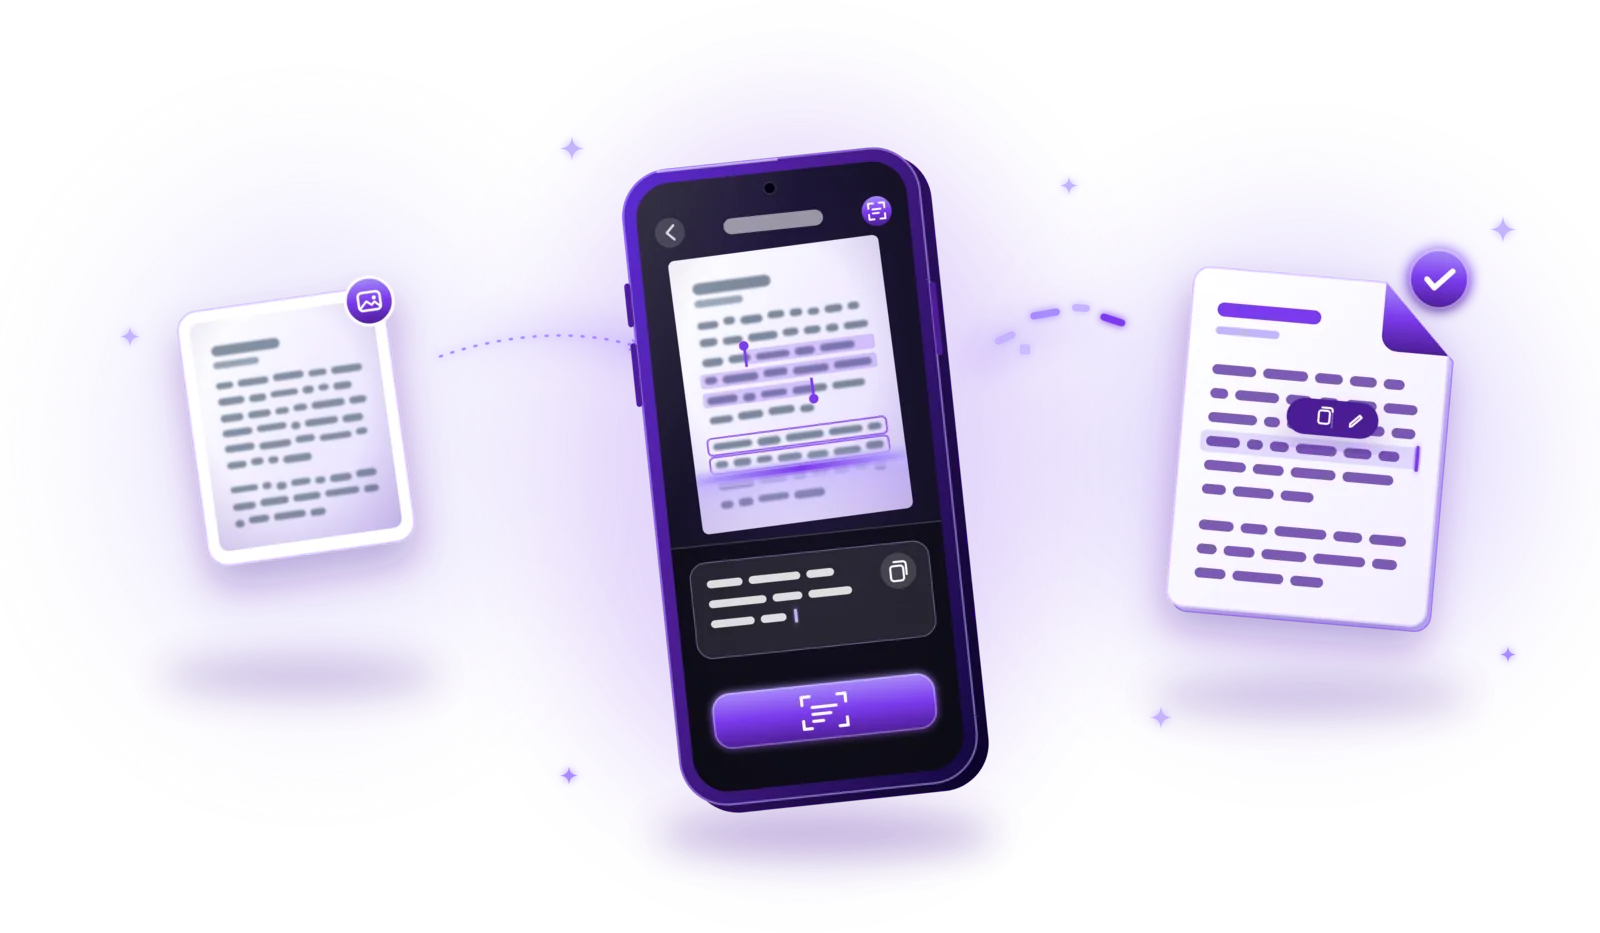
OCR, kurz für Optical Character Recognition (optische Zeichenerkennung), macht aus Bildern von Text echten, maschinenlesbaren Text. Ein Scan oder Foto einer Seite ist nur ein Bild: Du kannst es ansehen, die Wörter aber nicht suchen, kopieren oder bearbeiten. OCR wertet das Bild aus, erkennt die gedruckten (und manchmal handschriftlichen) Zeichen und gibt sie als Text aus. Um Text aus einem gescannten Dokument zu extrahieren, öffnest du es in einer App mit OCR, startest die Erkennung und kopierst oder speicherst das Ergebnis.
Gescannte Verträge
Eine Klausel in eine E-Mail kopieren oder einen Begriff in einem langen Vertrag finden, ohne jede Seite zu lesen.
Rechnungen und Belege
Beträge, Daten und Rechnungsnummern für die Buchhaltung übernehmen, statt sie abzutippen.
Text aus Fotos
Den Text von einem fotografierten Schild, Whiteboard oder Handzettel übernehmen.
Durchsuchbare Archive
Alte Dokumente über ein Wort finden, das darin vorkommt – nicht nur über den Dateinamen.
Briefe und Notizen
Korrespondenz und getippte Notizen digitalisieren, damit du sie später durchsuchen und zitieren kannst.
Gedruckten Text weiterverwenden
Text von einer gedruckten Seite in ein Dokument oder Formular übernehmen, ohne ihn abzutippen.
Text aus einem gescannten PDF extrahieren – Schritt für Schritt
Die Optionen unterscheiden sich von App zu App, aber der Ablauf sieht meist so aus:
Eine App mit OCR öffnen
Nimm einen Dokumentenscanner, eine PDF-App oder ein OCR-Werkzeug mit Texterkennung.
Ein gescanntes PDF importieren oder ein neues Dokument aufnehmen
Öffne einen vorhandenen Scan oder ein Bild, oder scanne das Dokument direkt. Fotos, die du schon hast, kannst du auch zuerst in PDF umwandeln.
Die Texterkennung auswählen
Such nach Optionen wie „OCR“, „Text erkennen“ oder „Text extrahieren“.
Bei Bedarf die Sprache wählen
Manche Werkzeuge fragen nach der Sprache, um das richtige Alphabet und Wörterbuch zu nutzen; andere erkennen sie automatisch.
Die Erkennung starten
Die App wertet jede Seite aus. Je nach Seitenzahl und Gerät dauert das einige Sekunden bis wenige Minuten.
Den erkannten Text prüfen
Vergleich das Ergebnis mit dem Original, besonders Namen, Zahlen, Beträge und Daten.
Erkennungsfehler korrigieren
Korrigiere falsch gelesene Zeichen wie 0 und O oder 1 und l, bevor du dich auf den Text verlässt.
Den Text kopieren, exportieren oder speichern
Kopiere ihn in die Zwischenablage, exportiere ihn als Textdatei oder speichere ihn als durchsuchbare Textebene im PDF – je nachdem, was die App kann.
Wie funktioniert optische Zeichenerkennung?
OCR-Software wertet visuelle Muster aus, ähnlich wie du beim Lesen Buchstaben erkennst. Vereinfacht läuft das in fünf Stufen ab:
- Bilderfassung: ein Scan oder Foto liefert das Bild der Seite.
- Vorverarbeitung: die Software richtet die Seite gerade, erhöht den Kontrast, entfernt Bildrauschen und trennt Text vom Hintergrund.
- Zeichen- und Worterkennung: sie findet Zeilen, Wörter und Zeichen und vergleicht deren Formen mit gelernten Mustern; moderne Engines nutzen maschinelles Lernen und betrachten ganze Wörter im Zusammenhang.
- Textextraktion: die erkannten Zeichen werden in Lesereihenfolge zu Wörtern, Zeilen und Absätzen zusammengesetzt.
- Ausgabe: das Ergebnis erscheint als reiner Text, wird als Datei gespeichert oder als unsichtbare Textebene ins PDF geschrieben.
Weil OCR mit dem arbeitet, was sie sieht, kann sie nicht lesen, was nicht klar sichtbar ist: Unscharfe, blasse oder verzerrte Zeichen sind die häufigste Fehlerquelle.
Gescanntes PDF vs. durchsuchbares PDF – was ist der Unterschied?
Nicht jedes PDF, das Text zeigt, enthält auch Text. Es gibt drei Arten:
| Merkmal | Reines Bild-PDF | Durchsuchbares PDF | Digital erstelltes PDF |
|---|---|---|---|
| Wie es entsteht | Gescannt oder fotografiert | Gescannt, dann fügt OCR eine Textebene hinzu | Aus Textverarbeitung oder anderem Programm exportiert |
| Text markier- und durchsuchbar | Nein | Ja | Ja |
| Was du siehst | Ein Bild der Seite | Dasselbe Bild der Seite | Aus Schriften dargestellten Text |
| Genauigkeit des Texts | Kein Text | So gut wie die OCR | Exakt |
Text zu extrahieren, macht ein PDF nicht automatisch durchsuchbar. Viele Apps zeigen den erkannten Text separat an oder lassen ihn kopieren, während das PDF selbst ein reines Bild bleibt. Für ein durchsuchbares PDF muss die App die erkannten Wörter als unsichtbare Ebene ins Dokument schreiben, genau über die passenden Wörter im Bild.
Denk an diese Ebene, wenn du das PDF später komprimierst: Werkzeuge, die Seiten als Bilder neu zeichnen, entfernen sie wieder.
So verbesserst du die OCR-Genauigkeit
Gute OCR beginnt mit einem guten Bild. Diese Tipps machen den größten Unterschied:
Klare, hochauflösende Scans
Kleine Schrift braucht genug Pixel. Ein scharfer Scan in normaler Dokumentqualität ist besser als ein großes, aber unscharfes Foto.
Gleichmäßiges Licht
Gleichmäßige Beleuchtung hilft der Software, Text vom Papier zu trennen.
Keine Schatten oder Spiegelungen
Schatten und Spiegelungen verdecken Teile der Zeichen. Verzichte auf glänzendem Papier auf den Blitz.
Flache Seiten
Gebogene Zeilen am Buchrücken oder auf gefaltetem Papier sind schwerer zu erkennen. Streich Seiten vor dem Scannen glatt.
Korrigierte Perspektive
Gerade, rechteckige Seiten mit waagerechten Zeilen liefern deutlich bessere Ergebnisse als schräge Fotos.
Die richtige Erkennungssprache
Wenn das Werkzeug eine Auswahl bietet, wähl die Sprache des Dokuments, damit Umlaute und Sonderzeichen erkannt werden.
Keine übermäßige Komprimierung
Stark komprimierte Bilder verwischen die Kanten der Buchstaben. Lass OCR vor dem Komprimieren laufen, nicht danach.
Das Ergebnis prüfen
Auch gute OCR macht Fehler. Prüf Zahlen, Namen und Beträge, bevor du den Text verwendest.
Die Genauigkeit hängt von der Qualität des Dokuments, der Sprache, den Schriften, ob der Text handschriftlich ist, und von der OCR-Engine selbst ab. Sauber gedruckter Text klappt meist sehr gut; ungewöhnliche Schriften, Tabellen und schlechte Scans führen zu mehr Fehlern.
Kann OCR handschriftlichen Text erkennen?
Manche OCR-Systeme erkennen Handschrift – oft Handschrifterkennung genannt –, die Ergebnisse schwanken aber stark, und nicht jede OCR-App unterstützt das. Saubere Druckbuchstaben funktionieren viel besser als Alltagshandschrift. Typische Schwierigkeiten:
- Schreibschrift: verbundene Buchstaben lassen sich schwer in einzelne Zeichen trennen.
- Undeutliche Zeichen: ein hastig geschriebenes a, o und u oder 1 und 7 sehen fast gleich aus.
- Gemischte Sprachen: Sprachwechsel im Text verwirren das Wörterbuch, auf das sich die Engine stützt.
- Ungewöhnliche Layouts: Randnotizen, Pfeile und schräger Text folgen keiner normalen Lesereihenfolge.
- Schlechte Bildqualität: blasser Bleistift, dünne Linien und wenig Kontrast machen Handschrift noch schwerer lesbar.
Behandle OCR-Ergebnisse bei handschriftlichen Dokumenten als Entwurf und prüf sie sorgfältig am Original.
Offline-OCR vs. Online-OCR
OCR kann auf einem entfernten Server oder direkt auf deinem Gerät laufen. Bei Verträgen, Finanzunterlagen und persönlichen Dokumenten macht das einen Unterschied.
| Merkmal | Online-OCR-Dienst | Offline-OCR-App |
|---|---|---|
| Wo die Erkennung passiert | Auf entfernten Servern | Auf deinem Gerät |
| Upload nötig | Meist ja | Nein |
| Internetverbindung | Nötig | Nicht nötig |
| Funktionsumfang | Kann erweiterte Erkennung bieten, z. B. für komplexe Layouts | Hängt von App und Gerät ab |
| Datenschutz | Hängt von Datenschutz- und Aufbewahrungspraxis des Dienstes ab | Dokumentinhalte werden zur Erkennung nicht hochgeladen |
Online-OCR-Dienste
Online-Dienste können leistungsfähig sein, aber dein Dokument wird hochgeladen und auf fremden Servern verarbeitet. Wie lange es gespeichert wird und wer darauf zugreifen kann, hängt von der Datenschutz- und Aufbewahrungspraxis des Anbieters ab – prüf sie, bevor du vertrauliche Dokumente hochlädst.
Offline-OCR-Apps
Offline-Apps erkennen Text lokal und funktionieren ohne Internetverbindung, Dokumentinhalte müssen dein Gerät zur Erkennung also nicht verlassen. Damit sind sie eine gute Wahl für Verträge, Finanzunterlagen und persönliche Daten. Vollständige Sicherheit garantiert Offline-Verarbeitung allein aber nicht: Schütze dein Gerät mit einer Bildschirmsperre und prüf, ob die App Dateien in eine Cloud synchronisiert. Siehe auch Dokumente offline scannen.
Bald verfügbar
Text extrahieren mit PDFDocify
PDFDocify, der Offline-Dokumentenscanner und die PDF-App von SlickLab, die gerade für den Start vorbereitet wird, hat eine Texterkennung für gedruckten Text. Nachdem du ein Dokument gescannt oder ein PDF importiert hast, liest „Text erkennen“ alle Seiten auf deinem Gerät. Danach kannst du den Text kopieren, als Textdatei exportieren oder darin nach Wörtern suchen, und der erkannte Inhalt macht deine Dokumente auch in der Bibliothek der App durchsuchbar. Auf Wunsch fügt PDFDocify den Text als unsichtbare Ebene ins PDF ein – als Kopie oder anstelle des Originals –, sodass das PDF auch in anderen Apps durchsuchbar wird. Die Texterkennung gehört zu PDFDocify Premium; Scannen und Ordnen sind kostenlos.
Kostenlos enthalten
- Unbegrenzt scannen
- Automatische Kantenerkennung und Perspektivkorrektur
- Filter: Auto, Schwarzweiß, Graustufen, Farbe, Original
- Mehrseitige PDFs: Seiten sortieren, drehen und löschen
- Fotos aus der Galerie importieren
- Dokumentbibliothek mit Ordnern, Suche und Sortierung
- PDFs mit jeder App teilen und exportieren
PDFDocify Premium
- Offline-OCR: Text kopieren und durchsuchen
- Durchsuchbare PDFs
- PDFs zusammenfügen
- PDFs komprimieren
- Handschriftliche Unterschriften
- Passwortschutz
- Stapelverarbeitung
Die Erkennung läuft komplett auf deinem Gerät, ohne Uploads. Bei passwortgeschützten PDFs musst du das Passwort vorher entfernen. Eine Internetverbindung brauchst du nur für In-App-Käufe.
Häufige Fragen
Wie extrahiere ich Text aus einem gescannten PDF?
Öffne das gescannte PDF in einer App mit OCR, starte die Texterkennung und prüf das Ergebnis. Danach kannst du den Text je nach App kopieren, exportieren oder als durchsuchbare Textebene im PDF speichern.
Was ist OCR?
OCR steht für Optical Character Recognition, auf Deutsch optische Zeichenerkennung. Die Software erkennt Buchstaben, Zahlen und Wörter in einem Bild, etwa einem Scan oder Foto, und macht daraus maschinenlesbaren Text.
Kann OCR ein Bild in bearbeitbaren Text umwandeln?
Ja. OCR extrahiert den Text aus einem Bild, sodass du ihn in eine Textverarbeitung oder E-Mail kopieren und dort bearbeiten kannst. Layout, Schriften und Tabellen werden meist nicht exakt übernommen, etwas Nacharbeit kann also nötig sein.
Kann ich ein gescanntes PDF durchsuchbar machen?
Ja, wenn deine App den erkannten Text als unsichtbare Textebene im PDF speichern kann. Die Seite sieht dann gleich aus, aber du kannst den Text in jedem PDF-Viewer markieren und durchsuchen. Text nur zu extrahieren, verändert das PDF nicht.
Funktioniert OCR mit handschriftlichen Dokumenten?
Manchmal. Manche OCR-Systeme erkennen Handschrift, die Ergebnisse schwanken aber stark, und viele Werkzeuge unterstützen nur gedruckten Text. Saubere Druckbuchstaben klappen am besten; Schreibschrift und undeutliche Schrift führen oft zu Fehlern.
Funktioniert OCR ohne Internetverbindung?
Ja, Offline-OCR-Apps erkennen Text direkt auf deinem Gerät. Online-Dienste brauchen eine Verbindung und laden dein Dokument hoch. PDFDocify erkennt Text offline.
Ist OCR immer genau?
Nein. Sauber gedruckter Text wird meist sehr gut erkannt, aber schlechte Scans, ungewöhnliche Schriften, komplexe Layouts und Handschrift führen zu Fehlern. Prüf wichtige Angaben wie Namen, Zahlen und Beträge immer nach.
Fazit
OCR macht aus gescannten Dokumenten und Fotos statt Bildern Text, den du kopieren, durchsuchen und weiterverwenden kannst. Gute Ergebnisse beginnen mit scharfen, flachen, gleichmäßig beleuchteten Scans, und ein kurzer Blick auf das Ergebnis findet die verbleibenden Fehler. Bei vertraulichen Dokumenten hält Offline-OCR die Inhalte auf deinem Gerät. Wenn du eine App suchst, die offline scannt, Text erkennt und PDFs durchsuchbar macht, sieh dir PDFDocify an und trag dich in die Warteliste für den Start ein.
Weitere Anleitungen
Dokumente als PDF scannen
Mit dem Smartphone aus Papier saubere PDFs machen: sieben Schritte vom Vorbereiten der Seite bis zur fertigen Datei, dazu Tipps für scharfe, private Scans.
Anleitung lesen
Bilder in PDF umwandeln
Fotos, JPGs und PNGs als PDF: einzelne Bilder umwandeln oder mehrere zu einem Dokument zusammenfassen – ohne Qualitätsverlust und ohne Upload.
Anleitung lesen
PDF-Dateien ohne Qualitätsverlust komprimieren
PDFs für E-Mail und Uploads verkleinern: die richtige Stufe wählen, Text lesbar halten und ohne Upload komprimieren.
Anleitung lesen
Dokumente offline und privat scannen
Ohne Internetverbindung scannen und vertrauliche Dokumente auf dem Gerät behalten: wie Offline-Scannen funktioniert und wie du deine Scans schützt.
Anleitung lesen