In questa guida
Che cos’è l’OCR e a cosa serve?
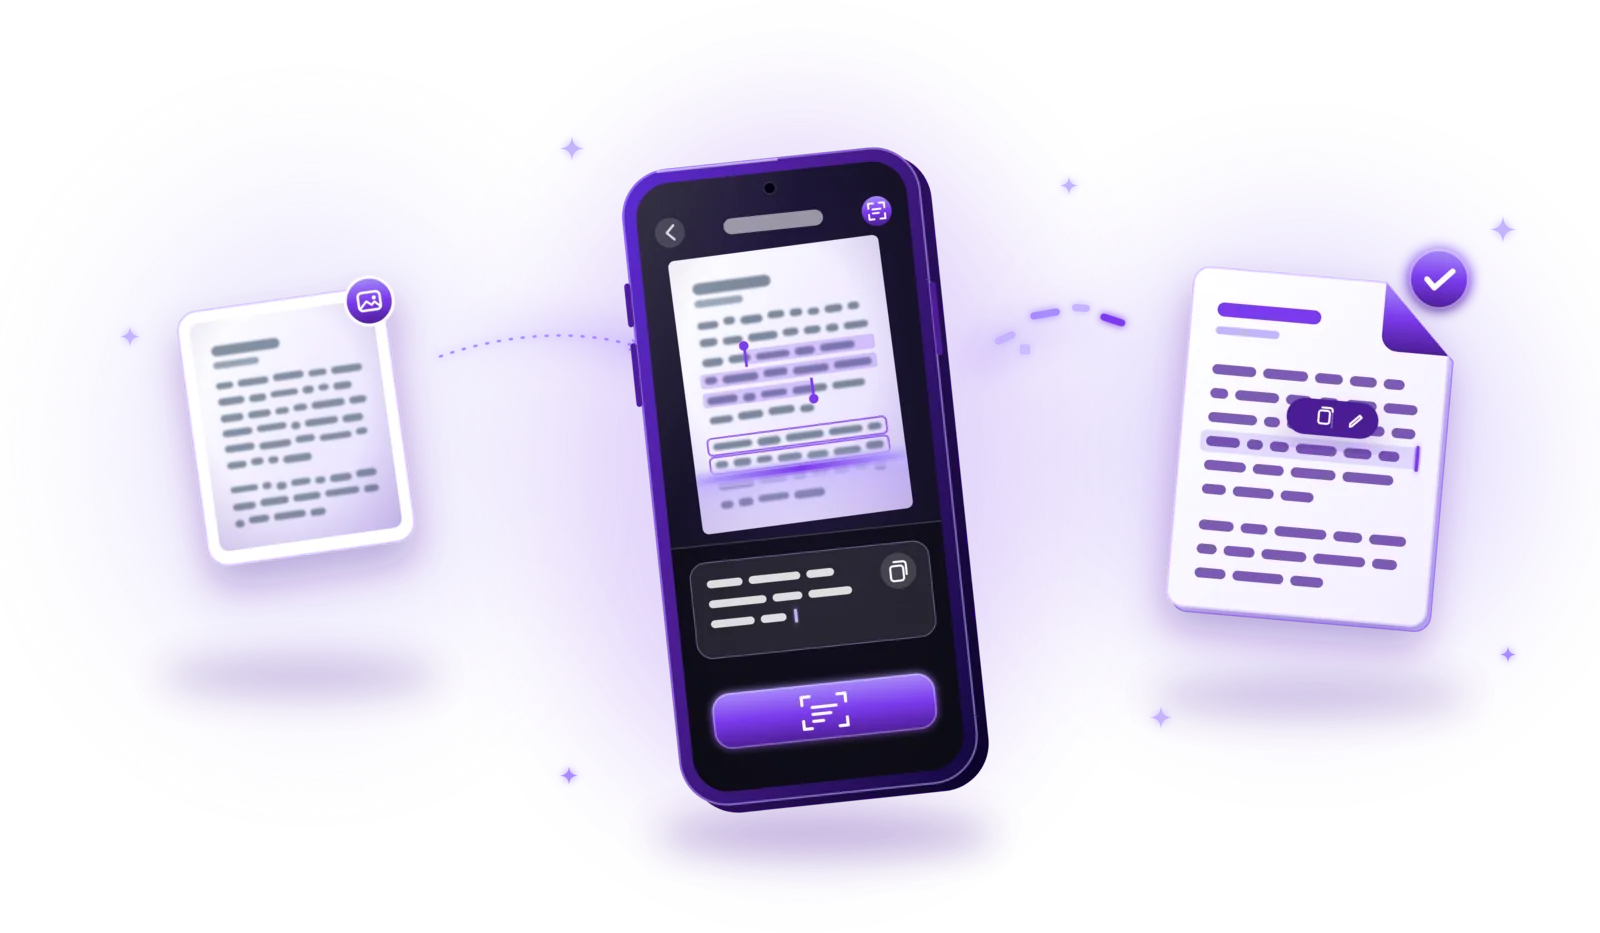
L’OCR, acronimo di optical character recognition (riconoscimento ottico dei caratteri), trasforma immagini di testo in testo vero e leggibile dal computer. La scansione o la foto di una pagina è solo un’immagine: puoi guardarla, ma non puoi cercare, copiare o modificare le parole. L’OCR analizza l’immagine, riconosce i caratteri stampati (e a volte scritti a mano) e li restituisce come testo. Per estrarre il testo da un documento scansionato, lo apri in un’app con OCR, avvii il riconoscimento e copi o salvi il risultato.
Contratti scansionati
Copia una clausola in un’email o trova un termine preciso in un lungo contratto senza leggere ogni pagina.
Fatture e scontrini
Ricava importi, date e numeri di fattura per la contabilità invece di ricopiarli dalla carta.
Testo dalle foto
Prendi il testo da un cartello, una lavagna o una dispensa stampata che hai fotografato.
Archivi ricercabili
Trova i vecchi documenti tramite una parola che contengono, non solo dal nome del file.
Lettere e appunti
Digitalizza corrispondenza e appunti battuti a macchina per poterli cercare e citare in seguito.
Riutilizzare testo stampato
Porta il testo di una pagina stampata in un documento o in un modulo senza riscriverlo.
Come estrarre il testo da un PDF scansionato: passo dopo passo
Le opzioni disponibili cambiano da un’app all’altra, ma di solito il processo OCR è questo:
Apri un’app con OCR
Usa uno scanner di documenti, un’app PDF o uno strumento OCR con una funzione di riconoscimento del testo.
Importa un PDF scansionato o acquisisci un nuovo documento
Apri una scansione o un’immagine esistente, oppure scansiona il documento direttamente. Le foto che hai già si possono anche convertire in PDF prima.
Scegli la funzione di riconoscimento del testo
Cerca voci come “OCR”, “Riconosci testo” o “Estrai testo”.
Scegli la lingua del documento, se richiesto
Alcuni strumenti chiedono la lingua per usare l’alfabeto e il dizionario giusti; altri la riconoscono da soli.
Avvia il riconoscimento
L’app analizza ogni pagina. A seconda del numero di pagine e del dispositivo, ci vogliono da pochi secondi a qualche minuto.
Controlla il testo riconosciuto
Confronta il risultato con l’originale, soprattutto nomi, numeri, importi e date.
Correggi gli errori di riconoscimento
Correggi i caratteri letti male, come 0 e O oppure 1 e l, prima di fidarti del testo.
Copia, esporta o salva il testo
Copialo negli appunti, esportalo come file di testo o salvalo nel PDF come livello di testo ricercabile, a seconda di ciò che l’app supporta.
Come funziona il riconoscimento ottico dei caratteri?
Il software OCR analizza schemi visivi, un po’ come fai tu quando riconosci le lettere leggendo. In modo semplificato, lavora in cinque fasi:
- Acquisizione dell’immagine: una scansione o una foto fornisce l’immagine della pagina.
- Pre-elaborazione: il software raddrizza la pagina, aumenta il contrasto, elimina i disturbi e separa il testo dallo sfondo.
- Riconoscimento di caratteri e parole: individua righe, parole e caratteri e ne confronta le forme con modelli appresi; i motori moderni usano il machine learning e guardano parole intere nel loro contesto.
- Estrazione del testo: i caratteri riconosciuti vengono ricomposti in parole, righe e paragrafi nell’ordine di lettura.
- Output: il risultato viene mostrato come testo semplice, salvato come file o riscritto nel PDF come livello di testo invisibile.
Poiché l’OCR lavora su ciò che vede, non può leggere ciò che non è ben visibile: i caratteri sfocati, sbiaditi o deformati sono la causa della maggior parte degli errori.
PDF scansionato e PDF ricercabile: qual è la differenza?
Non tutti i PDF che mostrano del testo contengono davvero testo. Ce ne sono di tre tipi:
| Aspetto | PDF solo immagine | PDF ricercabile | PDF creato digitalmente |
|---|---|---|---|
| Come nasce | Scansionato o fotografato | Scansionato, poi l’OCR aggiunge un livello di testo | Esportato da un programma di videoscrittura o da un altro software |
| Il testo si può selezionare e cercare | No | Sì | Sì |
| Cosa vedi | Un’immagine della pagina | La stessa immagine della pagina | Testo visualizzato con i caratteri tipografici |
| Precisione del testo | Nessun testo | Buona quanto l’OCR | Esatta |
Estrarre il testo non rende automaticamente ricercabile un PDF. Molte app mostrano il testo riconosciuto a parte o ti permettono di copiarlo, mentre il PDF stesso resta solo immagine. Per avere un PDF ricercabile, l’app deve scrivere le parole riconosciute nel documento come livello invisibile, posizionato sopra le parole corrispondenti nell’immagine.
Tieni presente questo livello quando in seguito vorrai comprimere il PDF: gli strumenti che ridisegnano le pagine come immagini lo eliminano di nuovo.
Come migliorare la precisione dell’OCR
Un buon OCR parte da una buona immagine. Questi consigli fanno la differenza più grande:
Scansioni nitide e ad alta risoluzione
I caratteri piccoli hanno bisogno di abbastanza pixel. Una scansione nitida in qualità documento normale è meglio di una foto grande ma sfocata.
Luce uniforme
Una luce omogenea su tutta la pagina aiuta il software a separare il testo dalla carta.
Niente ombre né riflessi
Ombre e riflessi nascondono parti dei caratteri. Evita il flash sulla carta lucida.
Pagine piatte
Le righe curve vicino alla rilegatura di un libro o sulla carta piegata sono più difficili da riconoscere. Appiattisci le pagine prima di scansionarle.
Prospettiva corretta
Pagine dritte e rettangolari con righe di testo orizzontali danno risultati molto migliori delle foto inclinate.
La lingua di riconoscimento giusta
Se lo strumento lo permette, scegli la lingua del documento, così accenti e caratteri speciali vengono riconosciuti.
Niente compressione eccessiva
Le immagini molto compresse sfocano i contorni delle lettere. Esegui l’OCR prima di comprimere, non dopo.
Controlla il risultato
Anche un buon OCR sbaglia. Verifica numeri, nomi e importi prima di usare il testo.
La precisione dipende dalla qualità del documento, dalla lingua, dai caratteri tipografici, dal fatto che il testo sia scritto a mano e dal motore OCR stesso. Il testo stampato pulito di solito funziona molto bene; caratteri insoliti, tabelle e scansioni scadenti producono più errori.
L’OCR riconosce il testo scritto a mano?
Alcuni sistemi OCR riconoscono la scrittura a mano (si parla di riconoscimento della scrittura manuale, o HTR), ma i risultati variano molto e non tutte le app OCR lo supportano. Lo stampatello ordinato funziona molto meglio della grafia di tutti i giorni. Le difficoltà tipiche sono:
- Corsivo: le lettere legate sono difficili da separare in singoli caratteri.
- Caratteri poco chiari: una a, una o e una u scritte in fretta, o un 1 e un 7, possono sembrare quasi identici.
- Lingue miste: passare da una lingua all’altra nello stesso testo confonde il dizionario su cui si basa il motore.
- Impaginazioni insolite: note a margine, frecce e testo inclinato non seguono il normale ordine di lettura.
- Qualità d’immagine scarsa: matita sbiadita, tratti sottili e poco contrasto rendono la scrittura a mano ancora più difficile da leggere.
Per i documenti scritti a mano, considera il risultato dell’OCR una bozza e confrontalo con attenzione con l’originale.
OCR offline e OCR online a confronto
L’OCR può funzionare su un server remoto o direttamente sul tuo dispositivo. Per contratti, documenti finanziari e documenti personali la differenza conta.
| Aspetto | Servizio OCR online | App OCR offline |
|---|---|---|
| Dove avviene il riconoscimento | Su server remoti | Sul tuo dispositivo |
| Caricamento necessario | Di solito sì | No |
| Connessione a internet | Necessaria | Non serve |
| Funzionalità | Può offrire un riconoscimento avanzato, per esempio per impaginazioni complesse | Dipende dall’app e dal dispositivo |
| Privacy | Dipende dalle pratiche di privacy e conservazione del servizio | Il contenuto dei documenti non viene caricato per il riconoscimento |
Servizi OCR online
I servizi online possono essere potenti, ma il tuo documento viene caricato ed elaborato sui server di qualcun altro. Per quanto tempo viene conservato e chi può accedervi dipende dalle pratiche di privacy e conservazione del fornitore, quindi verificale prima di caricare documenti riservati.
App OCR offline
Le app offline riconoscono il testo in locale e funzionano senza connessione a internet, quindi il contenuto dei documenti non deve lasciare il tuo dispositivo per il riconoscimento. Per questo sono una buona scelta per contratti, documenti finanziari e dati personali. L’elaborazione offline da sola però non garantisce una sicurezza totale: proteggi il dispositivo con un blocco schermo e controlla se l’app sincronizza i file con un cloud. Vedi anche come scansionare documenti offline.
In arrivo
Estrarre il testo con PDFDocify
PDFDocify, lo scanner di documenti e app PDF di SlickLab pensata per funzionare offline e ora in preparazione per il lancio, include il riconoscimento del testo stampato. Dopo aver scansionato un documento o importato un PDF, “Riconosci testo” legge tutte le pagine sul tuo dispositivo. Poi puoi copiare il testo, esportarlo come file di testo o cercarvi delle parole, e il contenuto riconosciuto rende i tuoi documenti ricercabili anche nell’archivio dell’app. Se vuoi, PDFDocify aggiunge il testo al PDF come livello invisibile, salvato come copia o al posto dell’originale, così il PDF diventa ricercabile anche in altre app. Il riconoscimento del testo fa parte di PDFDocify Premium; scansionare e organizzare i documenti è gratis.
Incluso gratis
- Scansioni illimitate
- Rilevamento automatico dei bordi e correzione della prospettiva
- Filtri: Auto, B/N, Scala di grigi, Colore, Originale
- PDF di più pagine: riordina, ruota ed elimina pagine
- Importa foto dalla galleria
- Libreria di documenti con cartelle, ricerca e ordinamento
- Condividi ed esporta PDF in qualsiasi app
PDFDocify Premium
- OCR offline: copia e cerca il testo
- PDF ricercabili
- Unisci PDF
- Comprimi PDF
- Firme autografe
- Protezione con password
- Elaborazione di più documenti insieme
Il riconoscimento avviene interamente sul tuo dispositivo, senza caricamenti. Ai PDF protetti da password va prima rimossa la password. La connessione a internet serve solo per gli acquisti in-app.
Domande frequenti
Come posso estrarre il testo da un PDF scansionato?
Apri il PDF scansionato in un’app con OCR, avvia il riconoscimento del testo e controlla il risultato. Poi, a seconda dell’app, puoi copiare il testo, esportarlo o salvarlo nel PDF come livello di testo ricercabile.
Che cos’è l’OCR?
OCR sta per optical character recognition, cioè riconoscimento ottico dei caratteri. È un software che riconosce lettere, numeri e parole in un’immagine, come una scansione o una foto, e li trasforma in testo leggibile dal computer.
L’OCR può trasformare un’immagine in testo modificabile?
Sì. L’OCR estrae il testo da un’immagine, così puoi copiarlo in un programma di videoscrittura o in un’email e modificarlo lì. Impaginazione, caratteri e tabelle di solito non vengono riprodotti esattamente, quindi potrebbe servire qualche ritocco alla formattazione.
Posso rendere ricercabile un PDF scansionato?
Sì, se la tua app può salvare il testo riconosciuto nel PDF come livello di testo invisibile. La pagina resta uguale, ma puoi selezionare e cercare il testo in qualsiasi visualizzatore PDF. Estrarre solo il testo non modifica il PDF.
L’OCR funziona con i documenti scritti a mano?
A volte. Alcuni sistemi OCR riconoscono la scrittura a mano, ma i risultati variano molto e molti strumenti supportano solo il testo stampato. Lo stampatello ordinato funziona meglio; il corsivo e la grafia poco chiara causano spesso errori.
L’OCR funziona senza connessione a internet?
Sì, le app OCR offline riconoscono il testo direttamente sul tuo dispositivo. I servizi online richiedono una connessione e caricano il tuo documento. PDFDocify riconosce il testo offline.
L’OCR è sempre preciso?
No. Il testo stampato pulito di solito viene riconosciuto molto bene, ma scansioni scadenti, caratteri insoliti, impaginazioni complesse e scrittura a mano portano a errori. Controlla sempre i dettagli importanti come nomi, numeri e importi.
Conclusione
L’OCR trasforma documenti scansionati e foto da semplici immagini in testo che puoi copiare, cercare e riutilizzare. I buoni risultati partono da scansioni nitide, piatte e ben illuminate, e un rapido controllo scova gli errori rimasti. Per i documenti riservati, l’OCR offline tiene il contenuto sul tuo dispositivo. Se cerchi un’app che scansiona, riconosce il testo e rende ricercabili i tuoi PDF offline, dai un’occhiata a PDFDocify e iscriviti alla lista d’attesa per il lancio.
Guide correlate
Come scansionare documenti in PDF
Trasforma la carta in PDF puliti con lo smartphone: sette passaggi dalla preparazione del foglio al salvataggio del file, più consigli per scansioni nitide e private.
Leggi la guida
Come convertire immagini in PDF
Trasforma foto, JPG e PNG in PDF: converti singole immagini o riuniscine diverse in un unico documento, senza perdere qualità né privacy.
Leggi la guida
Come comprimere file PDF senza perdere qualità
Rendi i PDF più leggeri per e-mail e caricamenti: scegli il livello di compressione giusto, mantieni il testo leggibile e comprimi senza caricare i tuoi file online.
Leggi la guida
Come scansionare documenti offline e in privato
Scansiona senza connessione a internet e tieni i documenti riservati sul tuo dispositivo: come funziona la scansione offline e come proteggere le tue scansioni.
Leggi la guida