En esta guía
¿Qué es el OCR y para qué sirve?
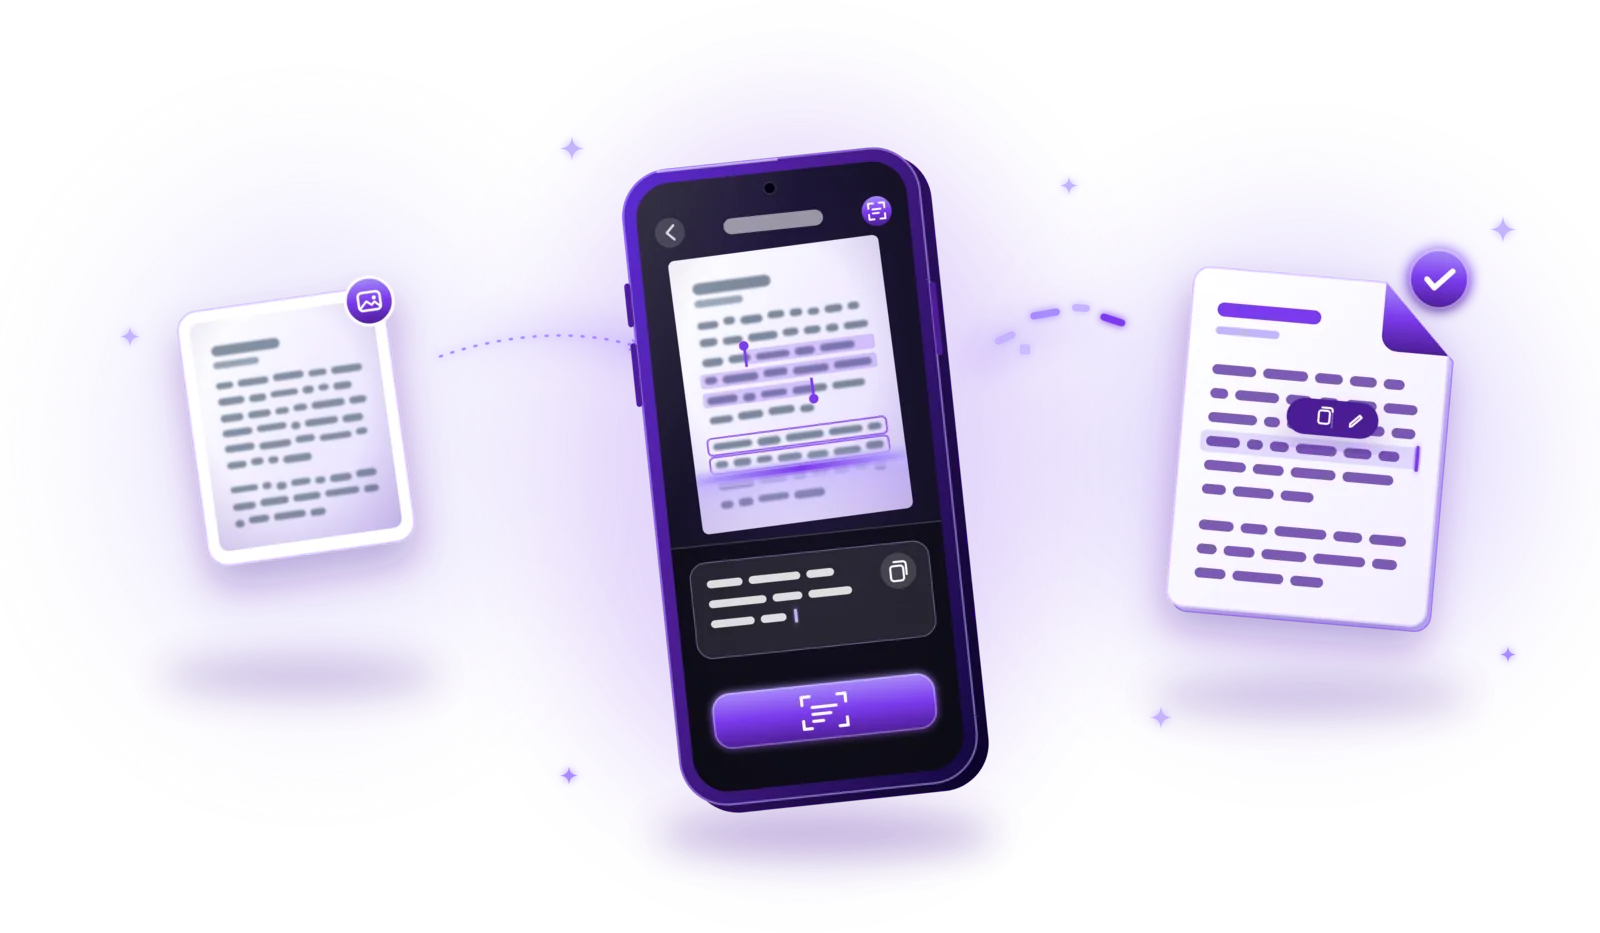
El OCR, siglas de Optical Character Recognition (reconocimiento óptico de caracteres), convierte imágenes de texto en texto real que una máquina puede leer. Un escaneo o una foto de una página es solo una imagen: puedes verla, pero no buscar, copiar ni editar las palabras. El OCR analiza la imagen, reconoce los caracteres impresos (y a veces manuscritos) y los devuelve como texto. Para extraer texto de un documento escaneado, ábrelo en una app con OCR, inicia el reconocimiento y copia o guarda el resultado.
Contratos escaneados
Copia una cláusula en un correo o encuentra un término en un contrato largo sin leer cada página.
Facturas y tiques
Toma importes, fechas y números de factura para la contabilidad en lugar de teclearlos.
Texto de fotos
Saca el texto de un cartel, una pizarra o un folleto impreso que hayas fotografiado.
Archivos con búsqueda
Encuentra documentos antiguos por una palabra que contienen, no solo por el nombre del archivo.
Cartas y apuntes
Digitaliza correspondencia y notas mecanografiadas para poder buscarlas y citarlas más adelante.
Reutilizar texto impreso
Lleva el texto de una página impresa a un documento o formulario sin volver a escribirlo.
Cómo extraer texto de un PDF escaneado, paso a paso
Las opciones cambian de una app a otra, pero el proceso de OCR suele ser así:
Abre una app con OCR
Usa un escáner de documentos, una app de PDF o una herramienta de OCR con reconocimiento de texto.
Importa un PDF escaneado o captura un documento nuevo
Abre un escaneo o una imagen que ya tengas, o escanea el documento directamente. Las fotos que ya tienes también puedes convertirlas a PDF primero.
Elige el reconocimiento de texto
Busca opciones como «OCR», «Reconocer texto» o «Extraer texto».
Elige el idioma del documento si hace falta
Algunas herramientas piden el idioma para usar el alfabeto y el diccionario correctos; otras lo detectan solas.
Inicia el reconocimiento
La app analiza cada página. Según el número de páginas y el dispositivo, tarda desde unos segundos hasta unos minutos.
Revisa el texto reconocido
Compara el resultado con el original, sobre todo nombres, cifras, importes y fechas.
Corrige los errores de reconocimiento
Corrige los caracteres mal leídos, como 0 y O o 1 y l, antes de fiarte del texto.
Copia, exporta o guarda el texto
Cópialo al portapapeles, expórtalo como archivo de texto o guárdalo en el PDF como capa de texto buscable, según lo que permita la app.
¿Cómo funciona el reconocimiento óptico de caracteres?
Un programa de OCR analiza patrones visuales, igual que tú reconoces las letras al leer. De forma simplificada, funciona en cinco fases:
- Captura de la imagen: un escaneo o una foto aporta la imagen de la página.
- Preprocesamiento: el programa endereza la página, aumenta el contraste, elimina el ruido y separa el texto del fondo.
- Reconocimiento de caracteres y palabras: localiza líneas, palabras y caracteres y compara sus formas con patrones aprendidos; los motores modernos usan aprendizaje automático y tienen en cuenta palabras completas en su contexto.
- Extracción del texto: los caracteres reconocidos se unen en palabras, líneas y párrafos en orden de lectura.
- Resultado: el texto se muestra como texto plano, se guarda en un archivo o se escribe en el PDF como capa invisible.
Como el OCR trabaja con lo que ve, no puede leer lo que no se ve con claridad: los caracteres borrosos, tenues o deformados son la principal fuente de errores.
PDF escaneado o PDF buscable: ¿cuál es la diferencia?
No todos los PDF que muestran texto contienen texto de verdad. Hay tres tipos:
| Aspecto | PDF de solo imagen | PDF buscable | PDF creado digitalmente |
|---|---|---|---|
| Cómo se crea | Escaneado o fotografiado | Escaneado y después el OCR añade una capa de texto | Exportado desde un procesador de textos u otro programa |
| El texto se puede seleccionar y buscar | No | Sí | Sí |
| Lo que ves | Una imagen de la página | La misma imagen de la página | Texto mostrado a partir de fuentes |
| Precisión del texto | No hay texto | Tan buena como el OCR | Exacta |
Extraer el texto no convierte automáticamente un PDF en buscable. Muchas apps muestran el texto reconocido por separado o permiten copiarlo, mientras el PDF sigue siendo solo una imagen. Para un PDF buscable, la app tiene que escribir las palabras reconocidas en el documento como capa invisible, colocada sobre las palabras correspondientes de la imagen.
Ten en cuenta esa capa cuando más adelante comprimas el PDF: las herramientas que redibujan las páginas como imágenes la eliminan.
Cómo mejorar la precisión del OCR
Un buen OCR empieza con una buena imagen. Estos consejos marcan la mayor diferencia:
Escaneos nítidos y con buena resolución
La letra pequeña necesita suficientes píxeles. Un escaneo nítido en calidad de documento es mejor que una foto grande pero borrosa.
Iluminación uniforme
Una luz uniforme sobre la página ayuda al programa a separar el texto del papel.
Sin sombras ni reflejos
Las sombras y los reflejos tapan partes de los caracteres. Evita el flash con papel brillante.
Páginas planas
Las líneas curvadas cerca del lomo de un libro o en papel doblado son más difíciles de reconocer. Alisa las páginas antes de escanear.
Perspectiva corregida
Las páginas rectas y rectangulares, con líneas horizontales, dan resultados mucho mejores que las fotos torcidas.
El idioma de reconocimiento correcto
Si la herramienta lo permite, elige el idioma del documento para que se reconozcan acentos y caracteres especiales.
Sin compresión excesiva
Las imágenes muy comprimidas difuminan los bordes de las letras. Pasa el OCR antes de comprimir, no después.
Revisa el resultado
Hasta un buen OCR se equivoca. Revisa cifras, nombres e importes antes de usar el texto.
La precisión depende de la calidad del documento, del idioma, de las fuentes, de si el texto está escrito a mano y del propio motor de OCR. El texto impreso limpio suele reconocerse muy bien; las fuentes poco habituales, las tablas y los escaneos malos producen más errores.
¿Puede el OCR reconocer texto escrito a mano?
Algunos sistemas de OCR pueden reconocer escritura a mano, lo que se suele llamar reconocimiento de escritura manuscrita, pero los resultados varían mucho y no todas las apps de OCR lo permiten. Las mayúsculas cuidadas funcionan mucho mejor que la letra de todos los días. Las dificultades típicas son:
- Letra cursiva: las letras unidas son difíciles de separar en caracteres individuales.
- Caracteres poco claros: una a, una o y una u o un 1 y un 7 escritos deprisa pueden parecer casi iguales.
- Idiomas mezclados: cambiar de idioma dentro del texto confunde al diccionario en el que se apoya el motor.
- Diseños poco habituales: las notas al margen, las flechas y el texto inclinado no siguen el orden de lectura normal.
- Mala calidad de imagen: el lápiz tenue, los trazos finos y el poco contraste hacen la letra aún más difícil de leer.
Con documentos manuscritos, trata el resultado del OCR como un borrador y revísalo con cuidado frente al original.
OCR sin conexión frente a OCR en línea
El OCR puede funcionar en un servidor remoto o directamente en tu dispositivo. Con contratos, documentos financieros e información personal, la diferencia importa.
| Aspecto | Servicio de OCR en línea | App de OCR sin conexión |
|---|---|---|
| Dónde se hace el reconocimiento | En servidores remotos | En tu dispositivo |
| Hay que subir el documento | Normalmente sí | No |
| Conexión a internet | Necesaria | No necesaria |
| Funciones | Puede ofrecer reconocimiento avanzado, p. ej. para diseños complejos | Depende de la app y del dispositivo |
| Privacidad | Depende de las prácticas de privacidad y conservación del servicio | El contenido de los documentos no se sube para reconocerlo |
Servicios de OCR en línea
Los servicios en línea pueden ser potentes, pero tu documento se sube y se procesa en servidores ajenos. Cuánto tiempo se guarda y quién puede acceder a él depende de las prácticas de privacidad y conservación del proveedor; revísalas antes de subir documentos delicados.
Apps de OCR sin conexión
Las apps sin conexión reconocen el texto en local y funcionan sin internet, así que el contenido de los documentos no tiene que salir de tu dispositivo para reconocerlo. Por eso son una buena opción para contratos, documentos financieros e información personal. Aun así, el procesamiento sin conexión no garantiza por sí solo una seguridad total: protege tu dispositivo con un bloqueo de pantalla y comprueba si la app sincroniza archivos con una nube. Consulta también cómo escanear documentos sin conexión.
Muy pronto
Extrae texto con PDFDocify
PDFDocify, el escáner de documentos y app de PDF sin conexión de SlickLab que se prepara para su lanzamiento, incluye reconocimiento de texto impreso. Después de escanear un documento o importar un PDF, «Reconocer texto» lee todas las páginas en tu dispositivo. Luego puedes copiar el texto, exportarlo como archivo de texto o buscar palabras en él, y el contenido reconocido también hace que tus documentos se puedan buscar en la biblioteca de la app. Si quieres, PDFDocify añade el texto al PDF como capa invisible, en una copia o sustituyendo el original, para que el PDF también se pueda buscar en otras apps. El reconocimiento de texto forma parte de PDFDocify Premium; escanear y organizar es gratis.
Incluido gratis
- Escaneo ilimitado
- Detección automática de bordes y corrección de perspectiva
- Filtros: Auto, Blanco y negro, Escala de grises, Color, Original
- PDF de varias páginas: reordena, gira y elimina páginas
- Importa fotos desde tu galería
- Biblioteca de documentos con carpetas, búsqueda y ordenación
- Comparte y exporta PDF a cualquier app
PDFDocify Premium
- OCR sin conexión: copia y busca texto
- PDF con texto buscable
- Combinar PDF
- Comprimir PDF
- Firmas manuscritas
- Protección con contraseña
- Procesamiento por lotes
El reconocimiento se hace por completo en tu dispositivo, sin subir nada. A los PDF protegidos con contraseña hay que quitarles la contraseña primero. Solo necesitas conexión a internet para las compras dentro de la app.
Preguntas frecuentes
¿Cómo puedo extraer texto de un PDF escaneado?
Abre el PDF escaneado en una app con OCR, inicia el reconocimiento de texto y revisa el resultado. Según la app, después puedes copiar el texto, exportarlo o guardarlo en el PDF como capa de texto buscable.
¿Qué es el OCR?
OCR son las siglas de Optical Character Recognition, reconocimiento óptico de caracteres. Es un programa que reconoce letras, números y palabras en una imagen, como un escaneo o una foto, y los convierte en texto que una máquina puede leer.
¿Puede el OCR convertir una imagen en texto editable?
Sí. El OCR extrae el texto de una imagen para que puedas copiarlo en un procesador de textos o un correo y editarlo allí. El diseño, las fuentes y las tablas no suelen reproducirse exactamente, así que puede hacer falta algo de formato.
¿Puedo hacer buscable un PDF escaneado?
Sí, si tu app puede guardar el texto reconocido en el PDF como capa invisible. La página se ve igual, pero puedes seleccionar y buscar el texto en cualquier visor de PDF. Extraer el texto por sí solo no cambia el PDF.
¿Funciona el OCR con documentos escritos a mano?
A veces. Algunos sistemas de OCR reconocen la escritura a mano, pero los resultados varían mucho y muchas herramientas solo admiten texto impreso. Las mayúsculas cuidadas funcionan mejor; la letra cursiva y poco clara suele dar errores.
¿Puede funcionar el OCR sin conexión a internet?
Sí, las apps de OCR sin conexión reconocen el texto directamente en tu dispositivo. Los servicios en línea necesitan conexión y suben tu documento. PDFDocify reconoce texto sin conexión.
¿Es el OCR siempre preciso?
No. El texto impreso limpio suele reconocerse muy bien, pero los escaneos malos, las fuentes poco habituales, los diseños complejos y la escritura a mano provocan errores. Revisa siempre los datos importantes, como nombres, cifras e importes.
Conclusión
El OCR convierte documentos escaneados y fotos, que son solo imágenes, en texto que puedes copiar, buscar y reutilizar. Los buenos resultados empiezan con escaneos nítidos, planos y bien iluminados, y una revisión rápida detecta los errores que queden. Para documentos delicados, el OCR sin conexión mantiene el contenido en tu dispositivo. Si buscas una app que escanee, reconozca texto y haga tus PDF buscables sin conexión, echa un vistazo a PDFDocify y apúntate a la lista de espera para su lanzamiento.
Guías relacionadas
Cómo escanear documentos a PDF
Convierte papeles en PDF limpios con tu móvil: siete pasos desde preparar la hoja hasta guardar el archivo, y consejos para escaneos nítidos y privados.
Leer la guía
Cómo convertir imágenes a PDF
Convierte fotos, JPG y PNG en PDF: una sola imagen o varias en un documento, sin perder calidad ni privacidad.
Leer la guía
Cómo comprimir archivos PDF sin perder calidad
Aligera tus PDF para el correo y las subidas: elige el nivel adecuado, mantén el texto legible y comprime sin subir tus archivos.
Leer la guía
Cómo escanear documentos sin conexión y con privacidad
Escanea sin conexión a internet y guarda tus documentos delicados en tu dispositivo: cómo funciona el escaneo sin conexión y cómo proteger tus escaneos.
Leer la guía