Neste guia
O que é o OCR e para que serve?
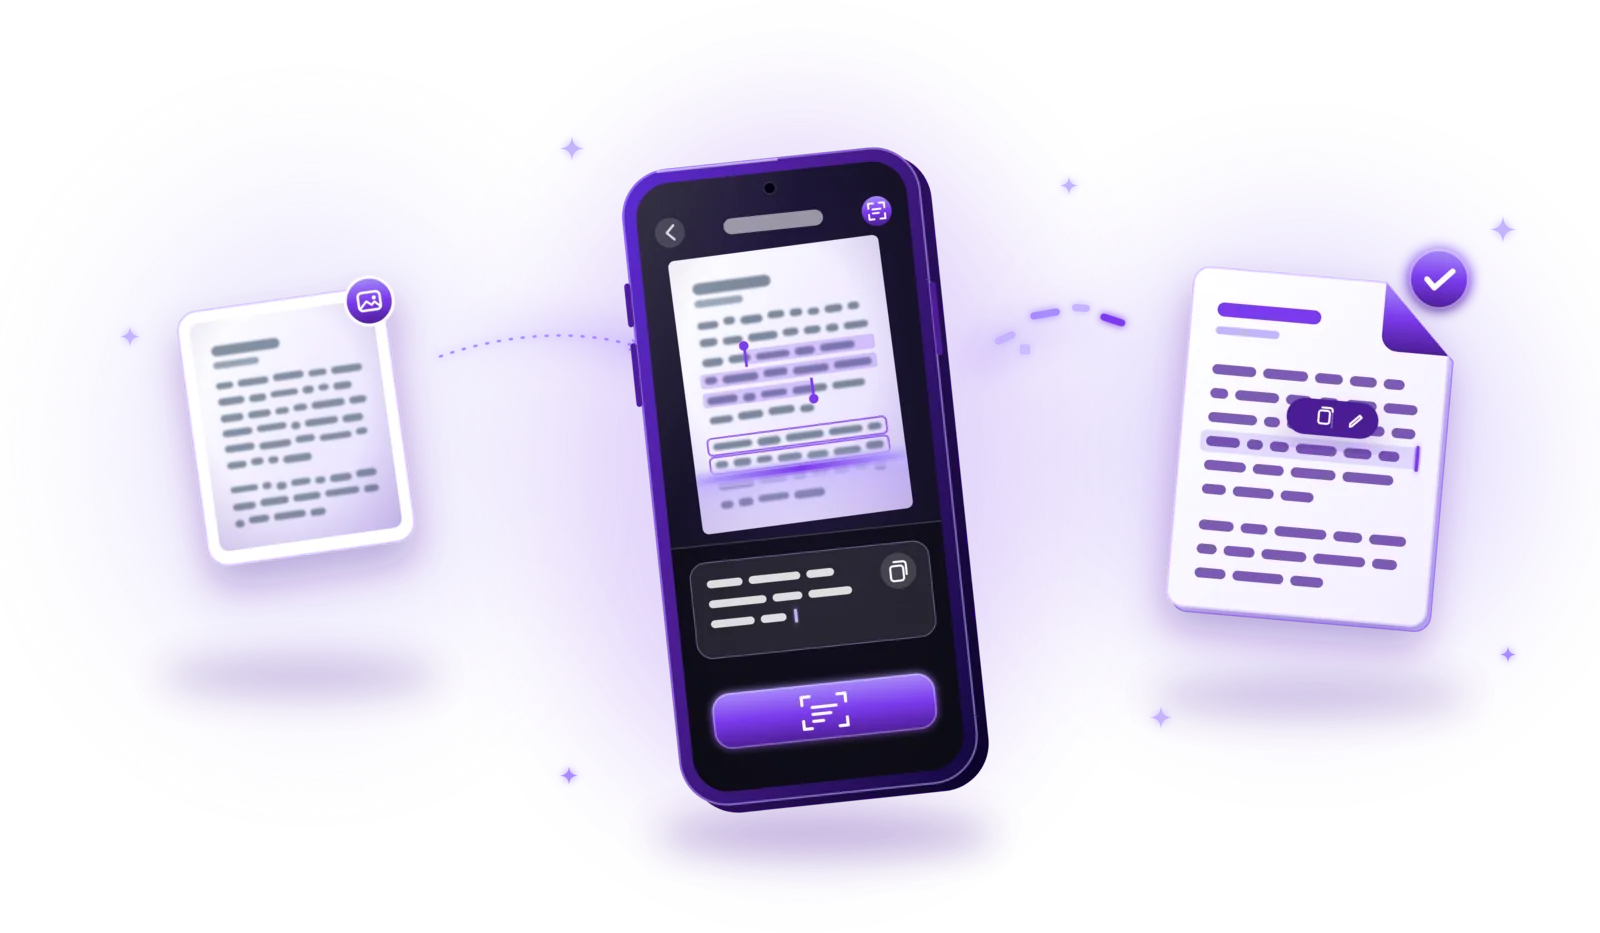
OCR, sigla inglesa de reconhecimento ótico de caracteres, transforma imagens de texto em texto real, legível por máquina. Uma digitalização ou fotografia de uma página é apenas uma imagem: pode vê-la, mas não pesquisar, copiar nem editar as palavras. O OCR analisa a imagem, reconhece os caracteres impressos (e por vezes manuscritos) e devolve-os como texto. Para extrair texto de um documento digitalizado, abre-o numa app com OCR, inicia o reconhecimento e copia ou guarda o resultado.
Contratos digitalizados
Copie uma cláusula para um e-mail ou encontre um termo num contrato extenso sem ler todas as páginas.
Faturas e recibos
Retire valores, datas e números de fatura para a contabilidade, em vez de os escrever a partir do papel.
Texto de fotografias
Aproveite o texto de uma placa, de um quadro branco ou de um folheto impresso fotografado.
Arquivos pesquisáveis
Encontre documentos antigos por uma palavra que contêm, e não apenas pelo nome do ficheiro.
Cartas e notas
Digitalize correspondência e notas datilografadas para as poder pesquisar e citar mais tarde.
Reutilizar texto impresso
Passe o texto de uma página impressa para um documento ou formulário sem o voltar a escrever.
Como extrair texto de um PDF digitalizado – passo a passo
As opções variam de aplicação para aplicação, mas o processo de OCR costuma ser este:
Abra uma app com OCR
Use um digitalizador de documentos, uma app de PDF ou uma ferramenta de OCR com função de reconhecimento de texto.
Importe um PDF digitalizado ou digitalize um documento novo
Abra uma digitalização ou imagem que já tenha, ou digitalize o documento diretamente. As fotografias que já tem também podem ser convertidas em PDF primeiro.
Escolha a função de reconhecimento de texto
Procure opções como «OCR», «Reconhecer texto» ou «Extrair texto».
Indique o idioma do documento, se for pedido
Algumas ferramentas pedem o idioma para usarem o alfabeto e o dicionário certos; outras detetam-no automaticamente.
Inicie o reconhecimento
A app analisa todas as páginas. Consoante o número de páginas e o dispositivo, demora entre alguns segundos e alguns minutos.
Reveja o texto reconhecido
Compare o resultado com o original, sobretudo nomes, números, valores e datas.
Corrija os erros de reconhecimento
Corrija caracteres mal lidos, como 0 e O ou 1 e l, antes de confiar no texto.
Copie, exporte ou guarde o texto
Copie-o para a área de transferência, exporte-o como ficheiro de texto ou guarde-o no PDF como camada de texto pesquisável, conforme o que a app permitir.
Como funciona o reconhecimento ótico de caracteres?
O software de OCR analisa padrões visuais, tal como reconhece letras quando lê. De forma simplificada, funciona em cinco fases:
- Captura da imagem: uma digitalização ou fotografia fornece a imagem da página.
- Pré-processamento: o software endireita a página, aumenta o contraste, remove ruído e separa o texto do fundo.
- Reconhecimento de caracteres e palavras: encontra linhas, palavras e caracteres e compara as suas formas com padrões que aprendeu; os motores modernos usam aprendizagem automática e analisam palavras inteiras no seu contexto.
- Extração do texto: os caracteres reconhecidos são agrupados em palavras, linhas e parágrafos pela ordem de leitura.
- Resultado: o texto é mostrado como texto simples, guardado num ficheiro ou gravado de novo no PDF como camada de texto invisível.
Como o OCR trabalha a partir do que consegue ver, não lê o que não está bem visível: caracteres desfocados, ténues ou distorcidos são a origem da maioria dos erros.
PDF digitalizado vs. PDF pesquisável – qual é a diferença?
Nem todos os PDF que mostram texto contêm realmente texto. Há três tipos:
| Aspeto | PDF só de imagem | PDF pesquisável | PDF criado digitalmente |
|---|---|---|---|
| Como é criado | Digitalizado ou fotografado | Digitalizado; depois o OCR acrescenta uma camada de texto | Exportado de um processador de texto ou de outro programa |
| O texto pode ser selecionado e pesquisado | Não | Sim | Sim |
| O que vê | Uma imagem da página | A mesma imagem da página | Texto desenhado a partir de tipos de letra |
| Precisão do texto | Não há texto | Tão boa quanto o OCR | Exata |
Extrair texto não torna automaticamente um PDF pesquisável. Muitas apps mostram o texto reconhecido à parte ou deixam copiá-lo, enquanto o próprio PDF continua a ser só imagem. Um PDF pesquisável exige que a app grave as palavras reconhecidas no documento como camada invisível, posicionada sobre as palavras correspondentes na imagem.
Tenha essa camada em conta quando mais tarde comprimir o PDF: as ferramentas que redesenham as páginas como imagens voltam a removê-la.
Como melhorar a precisão do OCR
Um bom OCR começa com uma boa imagem. Estas dicas são as que fazem mais diferença:
Digitalizações nítidas e com boa resolução
Letras pequenas precisam de píxeis suficientes. Uma digitalização nítida em qualidade normal de documento é melhor do que uma fotografia grande mas desfocada.
Iluminação uniforme
Uma luz igual em toda a página ajuda o software a separar o texto do papel.
Sem sombras nem reflexos
Sombras e reflexos escondem partes dos caracteres. Evite o flash em papel brilhante.
Páginas planas
Linhas curvas junto à lombada de um livro ou em papel dobrado são mais difíceis de reconhecer. Alise as páginas antes de digitalizar.
Perspetiva corrigida
Páginas direitas e retangulares, com linhas de texto niveladas, dão resultados muito melhores do que fotografias inclinadas.
O idioma de reconhecimento certo
Se a ferramenta permitir escolher, selecione o idioma do documento para que acentos e caracteres especiais sejam reconhecidos.
Sem compressão excessiva
Imagens muito comprimidas esbatem os contornos das letras. Faça o OCR antes de comprimir, não depois.
Reveja o resultado
Mesmo um bom OCR comete erros. Verifique números, nomes e valores antes de usar o texto.
A precisão depende da qualidade do documento, do idioma, dos tipos de letra, de o texto ser ou não manuscrito e do próprio motor de OCR. Texto impresso limpo costuma funcionar muito bem; tipos de letra invulgares, tabelas e más digitalizações produzem mais erros.
O OCR consegue reconhecer texto manuscrito?
Alguns sistemas de OCR conseguem reconhecer letra manuscrita, o chamado reconhecimento de texto manuscrito, mas os resultados variam muito e nem todas as aplicações de OCR o suportam. Letras de imprensa cuidadas funcionam muito melhor do que a letra do dia a dia. As dificuldades típicas são:
- Letra cursiva: as letras ligadas são difíceis de separar em caracteres individuais.
- Caracteres pouco claros: um a, o e u ou um 1 e um 7 escritos à pressa podem parecer quase iguais.
- Idiomas misturados: mudar de idioma a meio do texto confunde o dicionário em que o motor se apoia.
- Disposições invulgares: notas nas margens, setas e texto inclinado não seguem a ordem normal de leitura.
- Má qualidade de imagem: lápis ténue, traços finos e pouco contraste tornam a letra manuscrita ainda mais difícil de ler.
Em documentos manuscritos, trate o resultado do OCR como um rascunho e compare-o cuidadosamente com o original.
OCR offline vs. OCR online
O OCR pode ser feito num servidor remoto ou diretamente no seu dispositivo. Para contratos, documentos financeiros e documentos pessoais, essa diferença conta.
| Aspeto | Serviço de OCR online | App de OCR offline |
|---|---|---|
| Onde é feito o reconhecimento | Em servidores remotos | No seu dispositivo |
| Envio necessário | Normalmente sim | Não |
| Ligação à internet | Necessária | Não é necessária |
| Capacidades | Pode oferecer reconhecimento avançado, por exemplo para disposições complexas | Depende da app e do dispositivo |
| Privacidade | Depende das práticas de privacidade e de conservação do serviço | O conteúdo dos documentos não é enviado para o reconhecimento |
Serviços de OCR online
Os serviços online podem ser poderosos, mas o seu documento é enviado e processado nos servidores de outra entidade. Durante quanto tempo fica guardado e quem lhe pode aceder depende das práticas de privacidade e de conservação do fornecedor, por isso verifique-as antes de enviar documentos sensíveis.
Apps de OCR offline
As apps offline reconhecem o texto localmente e funcionam sem ligação à internet, por isso o conteúdo dos documentos não tem de sair do seu dispositivo para o reconhecimento. Isso torna-as uma boa escolha para contratos, documentos financeiros e informação pessoal. Ainda assim, o processamento offline não garante, por si só, segurança total: proteja o dispositivo com um bloqueio de ecrã e verifique se a app sincroniza ficheiros com uma nuvem. Veja também como digitalizar documentos offline.
Em breve
Extrair texto com o PDFDocify
O PDFDocify, o digitalizador de documentos e app de PDF da SlickLab pensado para funcionar offline, que está a ser preparado para o lançamento, inclui reconhecimento de texto impresso. Depois de digitalizar um documento ou importar um PDF, «Reconhecer texto» lê todas as páginas no seu dispositivo. Pode então copiar o texto, exportá-lo como ficheiro de texto ou procurar palavras nele, e o conteúdo reconhecido também torna os seus documentos pesquisáveis na lista de documentos da app. Se quiser, o PDFDocify acrescenta o texto ao PDF como camada invisível («Tornar o PDF pesquisável»), guardado como cópia ou substituindo o original, para que o PDF passe a ser pesquisável também noutras apps. O reconhecimento de texto faz parte do PDFDocify Premium; digitalizar e organizar documentos é gratuito.
Incluído gratuitamente
- Digitalização ilimitada
- Deteção automática de contornos e correção de perspetiva
- Filtros: Auto, Preto e branco, Tons de cinzento, Cor, Original
- PDF com várias páginas: reordene, rode e elimine páginas
- Importe fotografias da sua galeria
- Biblioteca de documentos com pastas, pesquisa e ordenação
- Partilhe e exporte PDF para qualquer app
PDFDocify Premium
- OCR offline: copie e pesquise texto
- PDF pesquisáveis
- Juntar PDF
- Comprimir PDF
- Assinaturas manuscritas
- Proteção com palavra-passe
- Processamento em lote
O reconhecimento é feito inteiramente no seu dispositivo, sem envios. Nos PDF protegidos por palavra-passe é preciso remover primeiro a palavra-passe. A ligação à internet só é necessária para compras na app.
Perguntas frequentes
Como posso extrair texto de um PDF digitalizado?
Abra o PDF digitalizado numa app com OCR, inicie o reconhecimento de texto e reveja o resultado. Depois, conforme a app, pode copiar o texto, exportá-lo ou guardá-lo no PDF como camada de texto pesquisável.
O que é o OCR?
OCR significa reconhecimento ótico de caracteres (do inglês «optical character recognition»). É um software que reconhece letras, números e palavras numa imagem, como uma digitalização ou fotografia, e as transforma em texto legível por máquina.
O OCR consegue converter uma imagem em texto editável?
Sim. O OCR extrai o texto de uma imagem para que o possa copiar para um processador de texto ou um e-mail e editá-lo lá. A disposição, os tipos de letra e as tabelas normalmente não são reproduzidos com exatidão, por isso pode ser preciso reformatar.
Posso tornar um PDF digitalizado pesquisável?
Sim, se a sua app conseguir guardar o texto reconhecido no PDF como camada de texto invisível. A página fica com o mesmo aspeto, mas pode selecionar e pesquisar o texto em qualquer visualizador de PDF. Extrair o texto, por si só, não altera o PDF.
O OCR funciona com documentos manuscritos?
Por vezes. Alguns sistemas de OCR reconhecem letra manuscrita, mas os resultados variam muito e muitas ferramentas só suportam texto impresso. Letras de imprensa cuidadas funcionam melhor; letra cursiva ou pouco clara dá muitas vezes erros.
O OCR funciona sem ligação à internet?
Sim, as apps de OCR offline reconhecem o texto diretamente no seu dispositivo. Os serviços online precisam de ligação e enviam o seu documento. O PDFDocify reconhece texto offline.
O OCR é sempre preciso?
Não. Texto impresso limpo costuma ser muito bem reconhecido, mas más digitalizações, tipos de letra invulgares, disposições complexas e letra manuscrita levam a erros. Verifique sempre os dados importantes, como nomes, números e valores.
Conclusão
O OCR transforma documentos digitalizados e fotografias, que são imagens, em texto que pode copiar, pesquisar e reutilizar. Os bons resultados começam com digitalizações nítidas, planas e bem iluminadas, e uma revisão rápida apanha os erros que restam. Para documentos sensíveis, o OCR offline mantém o conteúdo no seu dispositivo. Se procura uma app que digitaliza, reconhece texto e torna os seus PDF pesquisáveis offline, conheça o PDFDocify e inscreva-se na lista de espera para o lançamento.
Guias relacionados
Como digitalizar documentos para PDF
Transforme papel em PDF limpos com o telemóvel: sete passos desde preparar a folha até guardar o ficheiro, e dicas para digitalizações nítidas e privadas.
Ler o guia
Como converter imagens em PDF
Transforme fotografias, JPG e PNG em PDF: converta imagens individuais ou junte várias num só documento, sem perder qualidade nem privacidade.
Ler o guia
Como comprimir ficheiros PDF sem perder qualidade
Reduza o tamanho dos PDF para email e envios: escolha o nível de compressão certo, mantenha o texto legível e comprima sem carregar os seus ficheiros.
Ler o guia
Como digitalizar documentos offline e com privacidade
Digitalize sem ligação à internet e mantenha os documentos sensíveis no seu dispositivo: como funciona a digitalização offline e como proteger as suas digitalizações.
Ler o guia